先说结论:直播间监控不用复杂架构。2 核 4G 的轻量实例,每 30 秒轮询一次接口,只抓三个字段——在线人数、弹幕延迟、推流码率,写进 SQLite,异常时推 webhook。两条阈值就够用:在线人数连续两轮低于基线的 60%,推流码率低于 1500 kbps。
一、权限和密钥先分开
用管理员账号登录控制台,单独申请一套监控用的 API 密钥,别和主账号共用。密钥泄露等于把直播间数据交出去,这一步省不得。
- 监控密钥只给读权限,能查状态不能改配置;
- 密钥存在环境变量里,别写死在代码里;
- 换人接手时先轮换密钥,再交接;
- 实例用 2 核 4G 轻量容器,抓取任务跑得动。
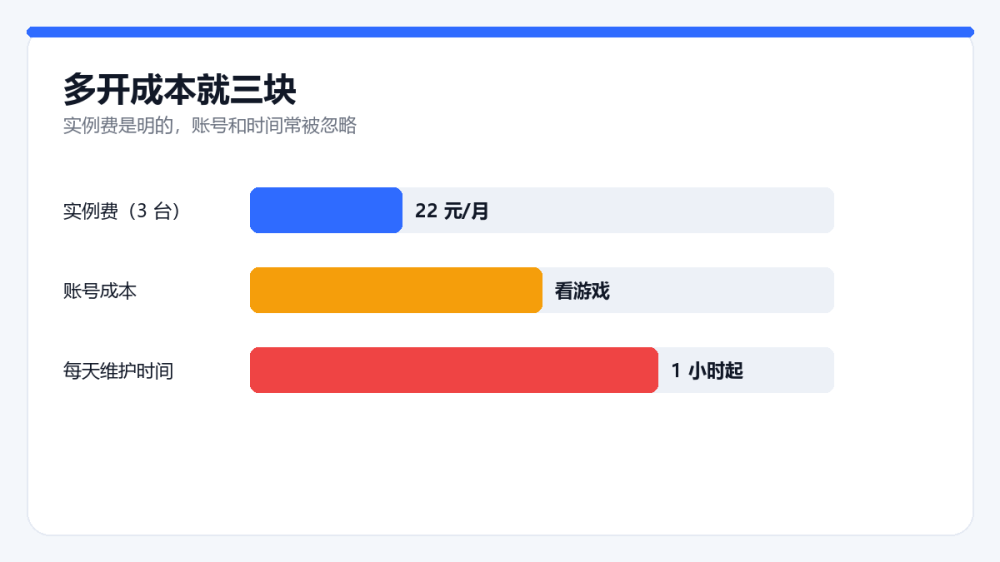
图:成本三块
二、采集只抓三个字段
字段越多,维护越累。三个够判断状态:
| 字段 | 阈值 | 说明 |
| 在线人数 | 连续两轮低于基线 60% | 掉人比掉线更早发生 |
| 弹幕延迟 | 超过 10 秒 | 延迟涨说明链路开始堵 |
| 推流码率 | 低于 1500 kbps | 码率掉,画面必糊 |
采集频率 30 秒一次。别一上来就搞 WebSocket,轮询够用,出问题也好查。数据落 SQLite,画一条折线,运营每天扫一眼就能看出异常时段。
三个字段的采集顺序也有影响。先取在线人数,再取码率,最后取弹幕延迟,因为延迟数据本身就是滞后的,放在前面会让时间戳对不齐。时间戳统一用服务器时间,别用本地时间,否则跨时区协作时对不上账。
三、告警怎么设计才有人看
告警发到企业微信或钉钉的 webhook 机器人,附带截图和那一段日志。只发一句「异常了」,值班的人还得自己去翻,等于没告警。
通知要分级。掉人是提醒,推流中断是紧急。值班按轮班排,深夜的告警只推紧急级别,否则几天之后所有人都会把群静音。
四、调参与维护
跑一两周再调参。轮询间隔可以从 30 秒缩到 15 秒,但接口调用量会翻倍,先确认调用频率上限,别把额度打满。
每月归档一次,把 30 天以前的数据挪出去。库文件太大,查询会明显变慢,告警也跟着延迟。
阈值不要照抄别人的。基线取自己直播间近两周的中位数,人少的场次按绝对值设下限,人多的场次按比例。拿大主播的阈值套小直播间,一天能报几十次警,报到最后没人看。
这套方案适合中小团队自建监控,不适合需要秒级响应的场景。轮询天生有延迟,30 秒的间隔意味着异常出现在两次抓取之间会被漏掉。要更细的粒度,就得换推送式接口,成本另算。部署完成后,实例价格对照基础版 15 元/月,多路直播间看高阶群控版 30 元/月,延迟判断参考延迟三段拆解。
Q:必须自建吗?
不一定。平台后台自带基础数据,自建的价值在告警和留存,看你要不要这两样。
Q:轮询会不会被限流?
会。先确认接口的频率上限,30 秒一次通常在安全范围内,缩到 15 秒前先测。
Q:数据存多久合适?
30 天在线,更早的归档。再长对排查帮助不大,只增加查询负担。
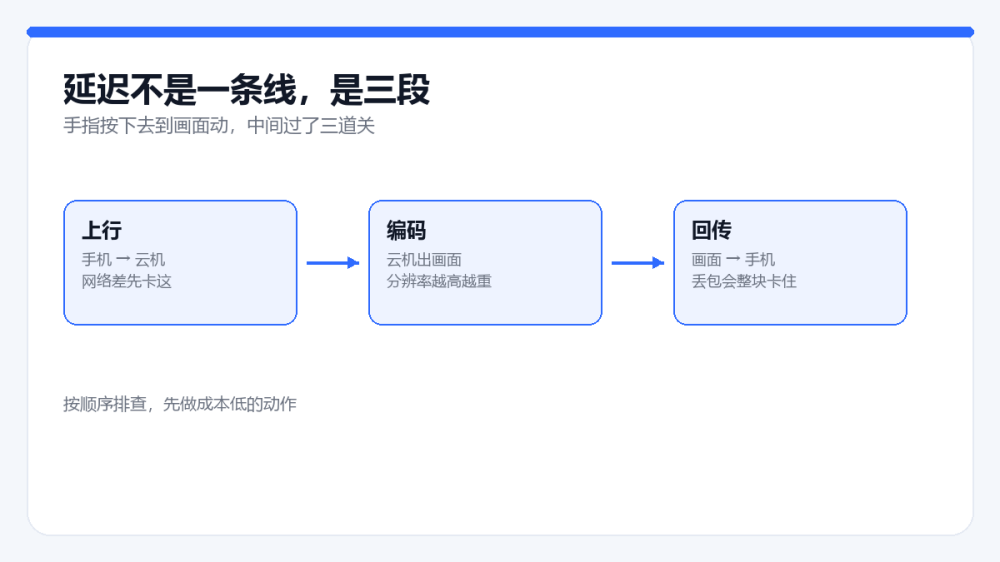
图:三段链路:卡在哪段调哪段
相关内容
- 云手机多开账号托管:多直播间集中管理。
- 云手机哪个好用:四项对比:稳定性怎么量化。
- 云手机套餐价格:监控实例怎么配。